多动态图详细讲解二叉搜索树
在计算机科学中,二叉搜索树(Binary Search Tree,有时称为有序或排序的二叉树)是一种能存储特定数据类型的容器。二叉搜索树允许快速查找、添加或者删除某一个节点,并且它是动态的集合。
二叉搜索树按照关键字顺序地保存节点,因此查找和其他操作可以使用二叉搜索原理:当在树(或者寻找插入新节点的地方)中查找节点时,它从根节点遍历到叶节点,与每个节点的关键字进行比较,然后基于比较结果,决定继续在左子树或者右子树中进行搜索。
平均而言,每次比较将跳过树的大约一半的元素,这使得每次查找,插入或删除一个节点所花费的时间与树的高度成正比,平均情况下就是节点个数的对数,比线性表的性能要好很多。
定义
二叉搜索树是以一棵二叉树来组织,每个节点就是一个对象,包括 key、卫星数据,除此之外还包括一些为了维持树结构所需要的信息:left、right、parent,分别指向左孩子、右孩子、父节点。其中如果孩子节点或者父节点不存在时,用 NIL 表示。根节点是树中唯一一个父节点为 NIL 的节点。
二叉搜索树具有以下性质:
- 如果节点的左子树不空,则左子树上所有结点的值均小于等于它的根结点的值;
- 如果节点的右子树不空,则右子树上所有结点的值均大于等于它的根结点的值;
- 任意节点的左、右子树也分别为二叉搜索树;
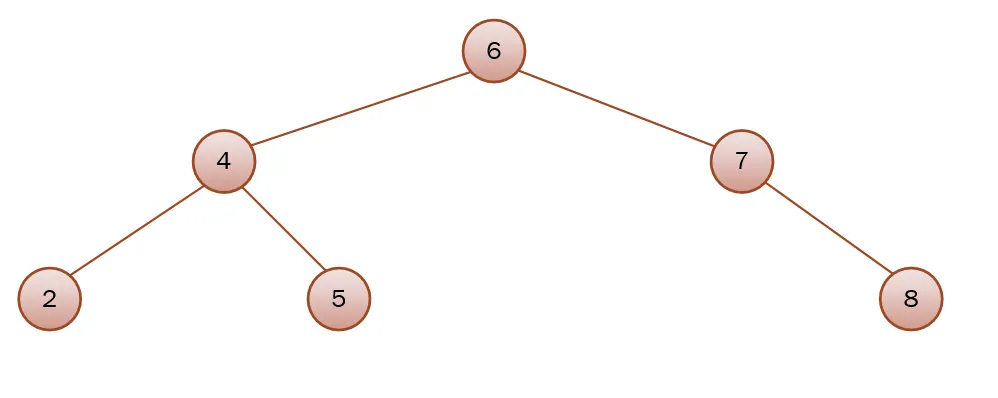
比如在上图中根节点的关键字为 6,左子树有关键字 2、4 和 5,均不大于 6;右子树有关键字 7 和 8,均不小于 6。这个性质对树中的每个节点都成立,也就是说,二叉搜索树的定义是递归的。
下面这棵树可以直接动手操作:查找、插入、删除都会从根节点开始逐个比较,删除时还会区分后文讲的三种情况。后面各节的例子都可以在这里重放。
初始的树包含了后文所有例子:插入 46,删除 19、58、62、68 分别对应不同的情况。
在讨论二叉搜索树的操作之前,先看看二叉搜索树的遍历。二叉搜索树可以使用先序遍历(preorder tree walk)、中序遍历(inorder tree walk)和后序遍历(postorder tree walk)。这样命名的依据是根据输出关键字相对于左右子树的位置。以中序遍历为例,伪代码如下:
INORDER-TREE-WALK(x)
    if x != nil  // 如果节点不为空
        INORDER-TREE-WALK(x.left)  // 首先递归地遍历左孩子,直到左孩子为空
        print x.key     // 输出当前节点(显然第一次运行到这里时,它是最小值,因为它是整棵树的最左节点)
        INORDER-TREE-WALK(x.right)  // 递归地遍历右孩子
对于定义中那棵以 6 为根的二叉搜索树,输出结果为 2,4,5,6,7,8,即按照从小到大的顺序排列。因为输出时一直遍历左孩子,直到遇到第一个左孩子为空的节点,将它输出,然后出栈返回继续输出。在上面的演示中点「中序遍历」,可以看到节点被依次访问的顺序。
查询
二叉搜索树还应该可以完成 MINIMUM,MAXIMUM,SUCCESSOR 和 PREDECESSOR 操作,即求最小值,最大值,后继和前驱,并且这些操作都可以在 O(h) 的时间内完成(h 为树的高度,平均情况下为 O(lg n))。
查找指定关键字
TREE-SEARCH 操作在二叉树中查找一个具有指定的关键字的节点,输入树的根节点指针和关键字 k,如果存在,返回节点指针,否则,返回 nil。伪代码如下:
TREE-SEARCH(x, k)
    if x == nil or k == x.key  //如不存在或者找到,直接返回
        return x
    if k < x.key                    //如果小于当前节点,根据性质,在左子树中搜索
        return TREE-SEARCH(x.left, k)
    else                          //如果大于等于当前节点,根据性质,在右子树中搜索
        return TREE-SEARCH(x.right, k)
比如查找关键字为 5 的节点,首先从根节点 6 开始,与 5 进行比较,因为 5 小于 6,因此在节点 6 的左子树继续搜索。到达节点 4 时因为 5 大于 4,所以在 4 节点的右子树搜索,这样就顺利找到了节点 5,此时函数将返回指向节点 5 的指针。
如果找不到目标节点,TREE-SEARCH 函数将返回 nil。在上面的演示中输入任意数字点「查找」,就能看到这样一步步比较的过程。
最小/最大关键字
通过从树根开始,沿着 left 孩子向下搜索,直到遇到 nil,那么根据二叉搜索树的性质,如果节点 x 没有左子树,而 x 的右子树的关键字肯定都大于 x.key,因此此时当前节点一定是整个树中的最小值。伪代码如下:
TREE-MINIMUM(x)
    while x.left != nil  // 沿着左子树一直深入搜索下去,直到遇到左子树为空的节点,此时当前节点为最小值
        x = x.left
    return x
同理,最大关键字的伪代码如下:
TREE-MAXIMUM(x)
    while x.right != nil  // 沿着右子树一直深入搜索下去,直到遇到右子树为空的节点,此时当前节点为最大值
        x = x.right
    return x
求取最大、最小关键字的时间复杂度仅为 O(h),即与树的高度成正比,因为查找过程自上而下形成一条线,线的最大长度为树的高度,如求取最小值的过程:
前驱/后继
给定二叉搜索树的一个节点,有时需要按照中序遍历的次序查找它的后继,如果所有的关键字互不相同,则一个节点 x 的后继一定是大于 x.key 的最小关键字。伪代码如下:
TREE-SUCCESSOR(x)
    if x.right != nil   //case 1:如果右子树不为空,则后继一定是右子树的最小值,即大于 x 的最小值(右子树的值都大于 x 节点)
        return TREE-MINIMUM(x.right)
    y = x.p    // case 2:右子树为空时
    while y != nil and x == y.right
        x = y   // 变量 x 代表节点原始 x 的祖先,如果找到 x,它是父节点的左孩子,则循环终止
        y = y.p   // y 代表节点 x 的父节点,如果 x 是 y 的左孩子,循环终止,并且返回 y
    return y
后继分两种情况。
情况一:x 的右子树不为空。如果 x 右子树不为空,那它的后继就是右子树的最左节点,对应伪代码 case 1。例如下图寻找 68 的后继,即寻找 68 的右子树的最小节点 72,同时它也是右子树的最左节点。
**情况二:x 的右子树为空。**注意 x 的后继始终是大于 x 的最小值(或者不存在),所以当 x 的右子树不存在时大于 x 的最小值在哪儿呢?我们只需要简单的从 x 开始沿树而上,找到第一个这样一个节点:它的父节点为空(即根节点)或者它的左孩子是 x 节点的祖先节点(不一定是直接祖先)。例如下图中为了寻找 17 的后继,沿着树上升,首先依次遇到了节点 13,11,它们均不符合条件,因为它们不是父节点的左孩子。当遇到节点 10 时,此时 x 指向节点 10,y 指向节点 19,并且节点 10 是节点 19 的左孩子,符合条件,所以返回节点 y,它是节点 x 的后继。
再举一个例子,下图为了找 15 的后继,仍然沿着树上升,直到遇到节点 10(此时伪代码中的变量 x 指向节点 10):它是 15 的祖先,而且是左孩子。所以此时返回节点 10 的父节点 19,即节点 15 的后继。
一个二叉搜索树中除了最大节点外,都有后继。对于前驱节点,和后继节点原理一样,这里不再赘述。
插入
插入操作会引起二叉搜索树集合的动态变化,因此需要一定的修改来维持二叉搜索树。由于二叉搜索树的性质,即左孩子小于等于父节点,右孩子大于等于父节点,因此插入操作相对简单。
将一个节点插入到二叉搜索树中,需要调用 TREE-INSERT,该过程以节点 z 作为输入,其中 z.left = nil, z.right = nil, z.key = 将要插入数据的关键字:
TREE-INSERT(T, z)
    y = nil
    x = T.root
    while x != nil //循环结束后,x 一定为空,此时 x 即为节点 z 要插入的地方
        y = x    //在这里给 y 赋值,保证循环结束后 y 始终是 x 的父节点
        if z.key < x.key
            x = x.left
        else
            x = x.right
    z.p = y  //  y 始终是 x 的父节点,为了插入 z,需要让 z 的父节点指向 x 的父节点,即指向 y
    if y == nil  //  如果 y 为空,说明插入时是一棵空的树,需要将树根指向 z
        T.root = z
    elseif z.key < y.key   //  判断节点 z 是 y 的左孩子还是右孩子
        y.left = z
    else
        y.right = z
上述伪代码从树根开始,指针 x 记录了一条向下的简单路径,通过 while 循环比较 z.key 和 x.key 的大小,使指针 x 和指针 y 向下移动,循环结束时则找到一个空的 x 并作为一个槽,将节点 z 放到这里(插入),同时保持节点 y 为节点 x 的父节点,这样可以很方便的决定插入之后将 z 作为它的左孩子还是右孩子。
举一个例子,在上面演示的初始树中输入 46 并点「插入」:为了在树中插入节点 46,首先 x 指向根节点,节点 46 与根节点 68(x 节点)比较,小于 68,因此指针 x 指向根节点(x 节点)的左孩子 62,然后一直下移。
注意当 x 指向 45 的时候,节点 46 大于 45,因此将 x 指向节点 45 的右孩子,此时 x 为 nil 了,循环结束,也就找到了节点 46 的位置:节点 45 的右孩子。然后进行一些操作将节点 46 插入到树中即可。
删除
从二叉搜索树中删除一个节点 z 稍微有点棘手,但总的来说可以分为三种情况:
- 如果
z没有孩子节点,那么简单的将它删除,并修改它的父节点,用nil作为孩子节点代替z即可; - 如果
z只有一个孩子,那么将这个孩子提升到z的位置,并修改它的父节点,用z的孩子代替z即可; - 如果
z有两个孩子,那么用z的后继y(此时z的后继y一定在z的右子树中,因为z的右孩子不为空)来占据z的位置,此时z的原来的右子树部分成为y的新的右子树,并且z的左子树成为y的新的左子树。这种情况稍微麻烦,因为还与y是否为z的右孩子相关。
第一种情况:节点 z 没有孩子
这种情况比较简单,我们直接删除节点 z 即可,并不会影响到二叉搜索树的性质:
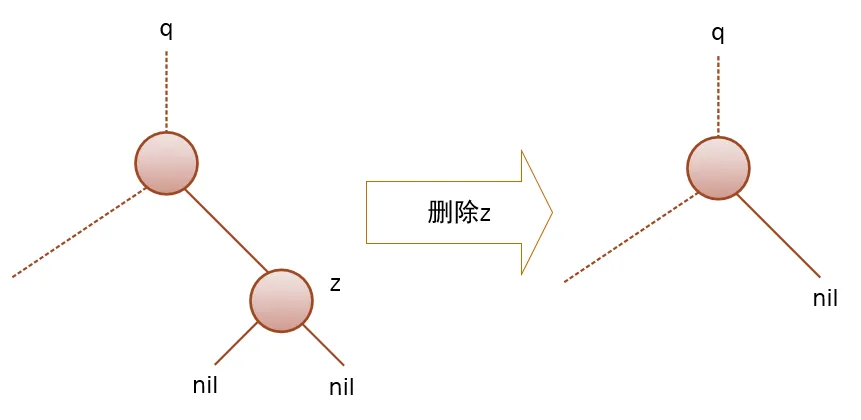
在上面的演示中删除 19、66 或 85 就是这种情况。
第二种情况:节点 z 只有一个孩子
这种情况也比较简单,直接用节点 z 的孩子代替节点 z 即可。其实第一种情况和第二种情况可以归为一个:节点 z 的孩子个数小于 2 个,直接用节点 z 的孩子代替节点 z 即可,只是节点 z 没有孩子时是用的 nil 代替节点 z,这里为了更加清楚地说明分了三种情况。
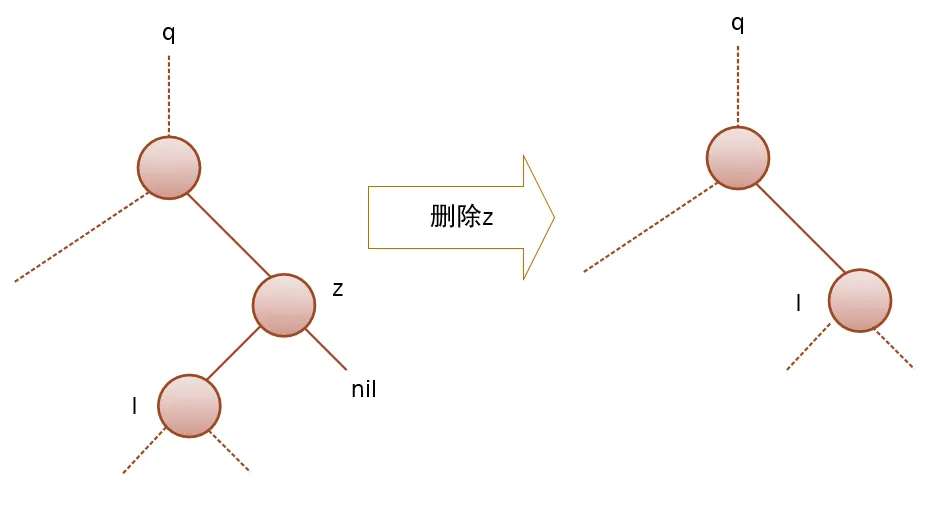
例如在上面演示的初始树中,节点 58 只有左孩子 45,删除 58 时直接将 58 的父节点 62 的左孩子指向节点 45,将节点 45 的父节点设置为节点 62 即可,45 下面的整棵子树跟着上移一层。只有右孩子时也是如此,比如删除只有右孩子 66 的节点 63。
第三种情况:节点 z 有两个孩子
这种情况稍微复杂一点,因为此时我们需要找到节点 z 的后继 y,而后继节点 y 又分为 y 是节点 z 的直接右孩子或者不是。
y 是 z 的右孩子
此时可以直接用后继 y 代替 z,而且 y 的左孩子此时一定为空(因为后继的左孩子一定为空),再用 z 的左孩子代替 y 的原来为空的左孩子即可。
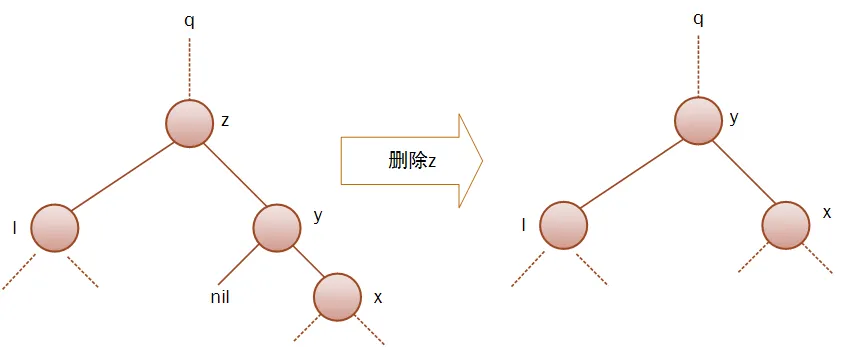
在上面的演示中删除 62 就是这种情况:它的后继 63 正是它的右孩子,63 直接上移接替 62,62 的左子树挂到 63 的左边。
y 不是 z 的右孩子
在这种情况下我们先用 y 的右孩子 x 代替 y,然后再用 y 代替 z:
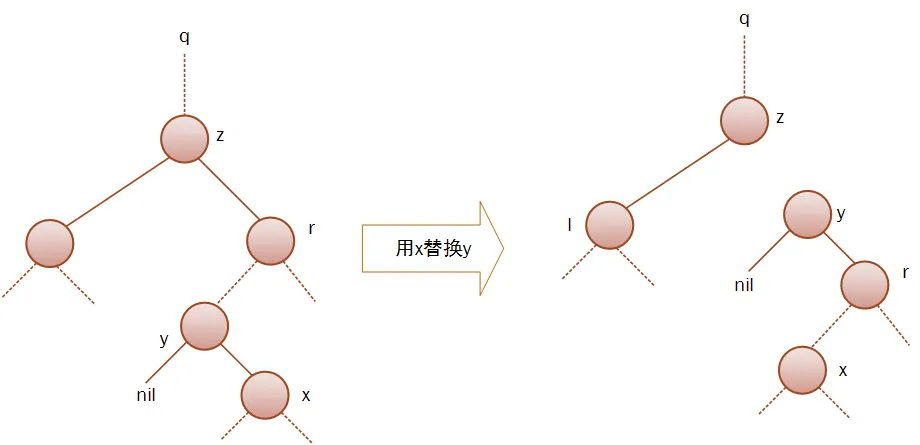
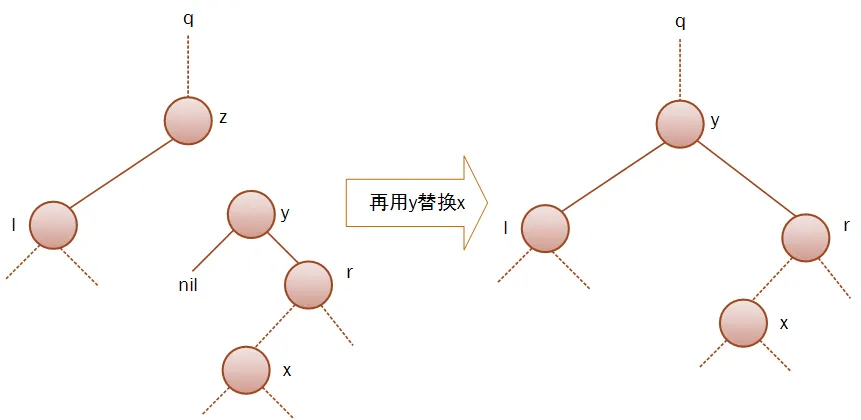
在上面的演示中删除根节点 68 就是这种情况:它的后继是 82(68 的右子树中最左的节点),而 82 是 94 的左孩子。于是先用 82 的右孩子 85 代替 82,即将 94 的左孩子指向 85,85 的父节点设置为 94;然后再用 82 代替 68,即将 68 的左孩子 62 设置为 82 的左孩子,68 的右孩子 94 设置为 82 的右孩子。
以上是三种情况的思路。为了实现删除过程的伪代码,我们需要定义一个子过程 TRANSPLANT,它是为了用以 v 为根的子树替换以 u 为根的子树,让 u 的双亲节点变为 v 的双亲节点,即让 v 成为 u 的双亲节点的孩子:
TRANSPLANT(T, u, v)
    if u.p == nil   // 当 u 为树的根节点时,直接将树的根节点指向 v
        T.root = v
    elseif u == u.p.left   // 如果 u 是左孩子,则 u 的父节点的左孩子指向 v
        u.p.left = v
    else    // 如果 u 是右孩子,则 u 的父节点的右孩子指向 v
        u.p.right = v
    if v != nil
        v.p = u.p    // 将 v 的父节点设为 u 的父节点
有了 TRANSPLANT,就可以实现具体的删除过程:
TREE-DELETE(T, z)
    if z.left == nil  // 如果左孩子为空,则直接用右孩子代替 z 即可,而不管右孩子是否为空(右孩子为空时对应情况一否则对应情况二)
        TRANSPLANT(T, z, z.right)
    elseif z.right == nil  // 右孩子为空,直接用左孩子代替 z
        TRANSPLANT(T, z, z.left)
    else y = TREE-MINIMUM(z.right)  // 左右孩子均不为空,找到 z 的后继 y,即 z 的右子树的最小值,对应第三种情况
        if y.p != z   // 如果 z 的后继 y 不是 z 的右孩子,对应第三种情况的 2
            TRANSPLANT(T, y, y.right)  // 用 y 的右孩子代替 y
            y.right = z.right    // 将 y 的右孩子指向 z 的右孩子
            y.right.p = y     // 将 y 的右孩子 (原来的 z 的右孩子) 的父节点设为 y
        TRANSPLANT(T, z, y)  // 用 y 代替 z
        y.left = z.left
        y.left.p = y
因此总的来说,删除操作可以分为两大类:
z的孩子总数小于 2 时,直接用z的孩子代替z即完成了对z的删除;z有两个孩子时:z的后继y是z的右孩子:直接用y代替z即可(别忘了将z的左孩子的父节点设置为y);z的后继y不是z的右孩子:先用y的右孩子x代替y,再用y代替z。
总结
因为二叉搜索树的性质,即可以在每个比较之后将数据规模变为原来的一半,因此平均情况下每一个操作都可以在 O(lg n) 的时间内完成,即花费时间与树的高度成正比。但在最坏的情况下(比如按从小到大的顺序依次插入),二叉搜索树就退化为一个链表,此时的时间复杂度退化到了 O(n)。
但很多改进版的二叉查找树可以使树高保持在 O(lg n),如 SBT,AVL 树,红黑树等。
参考
- Thomas H. Cormen 等,《算法导论》(第 3 版)第 12 章「二叉搜索树」
- 维基百科:二元搜索树
- VisuAlgo:二叉搜索树可视化